Generator llms.txt i test dostępu botów AI do Twojej strony
Wpisz adres strony, a w najwyżej 20 sekund dostaniesz cały plik llms.txt z mapy strony i test dostępu 8 botów AI. Bez rejestracji i bez e-maila.
Krótka odpowiedź
llms.txt to plik w formacie Markdown w katalogu głównym strony, który wskazuje modelom językowym najważniejsze podstrony z krótkim opisem. To propozycja standardu (llmstxt.org), a nie wymóg: według analizy Ahrefs żaden duży dostawca modeli oficjalnie go nie obsługuje. Dla ChatGPT ważniejsze jest, czy boty AI mają dostęp do strony w robots.txt. Generator sprawdza oba elementy.
Co dostajesz za darmo
Od razu, bez e-maila i rejestracji
- Cały plik llms.txt w formacie llmstxt.org: nagłówek z nazwą, opis firmy i sekcje z linkami do podstron.
- Tytuł przy każdym linku i opis z meta description podstrony, jeśli go ma.
- Sekcje według katalogów i wersji językowych, a regulamin i polityki w sekcji „Optional”.
- Edytor przed pobraniem: odznaczanie linii, zmiana tytułów, opisów, kolejności i sekcji.
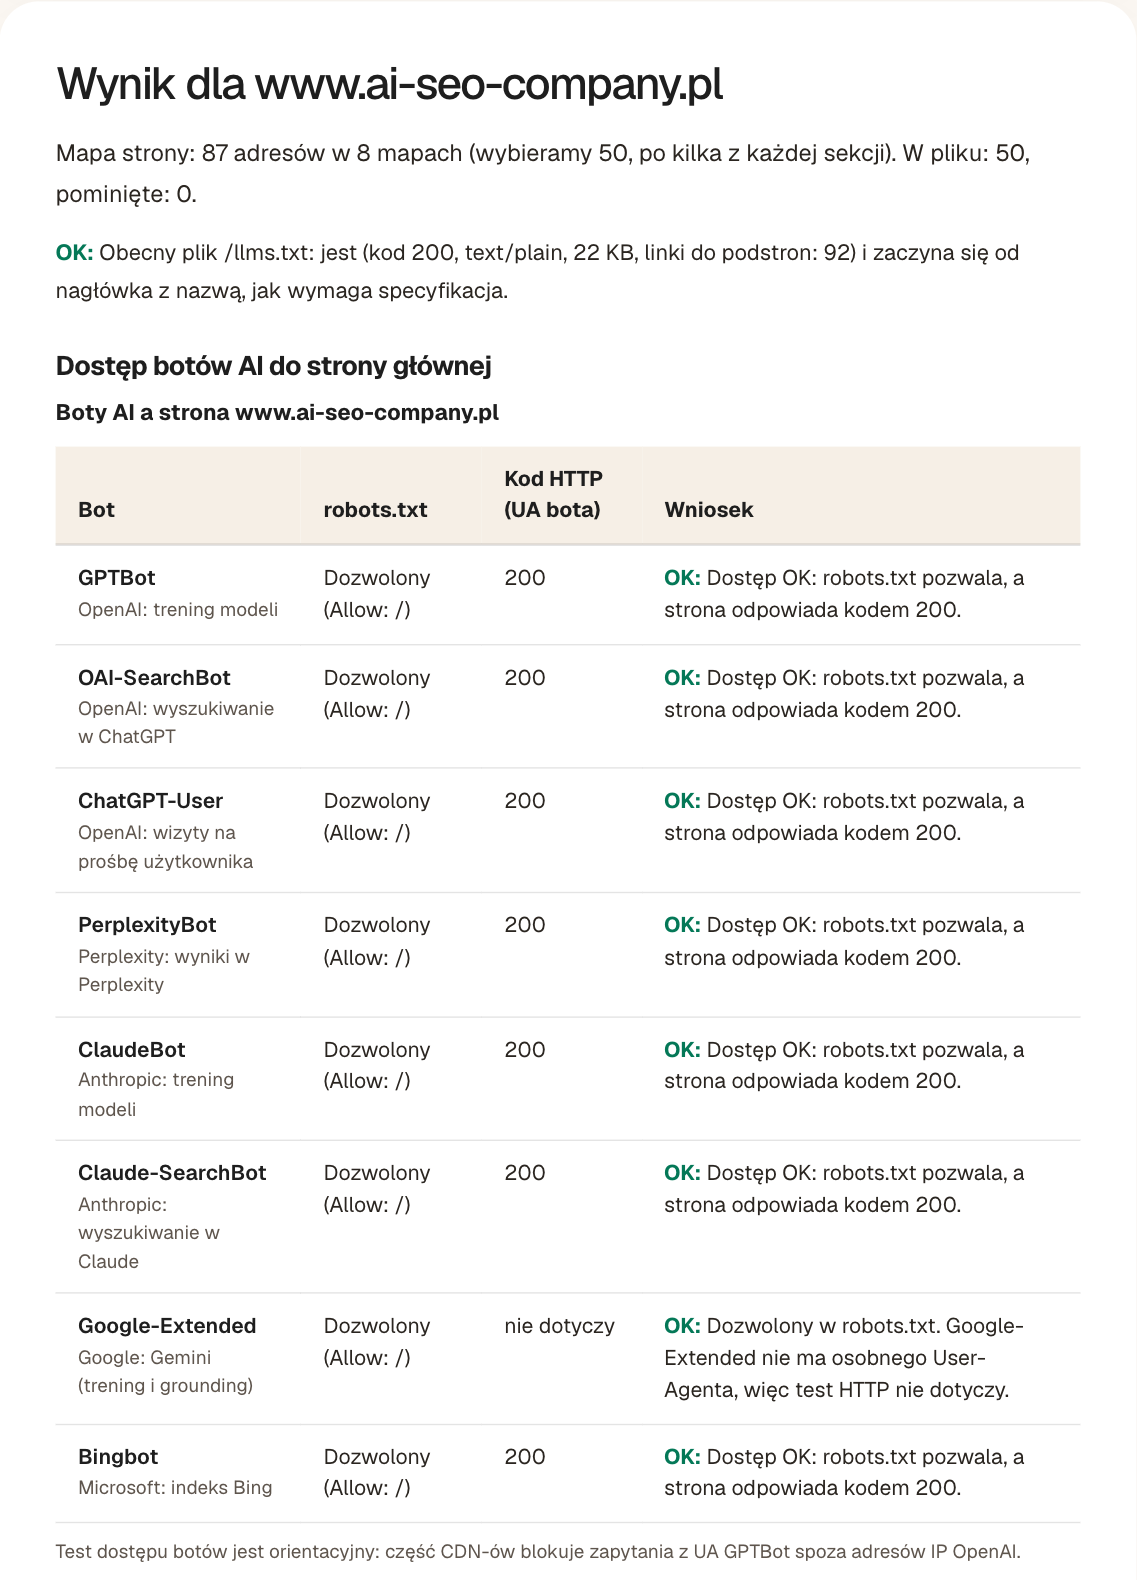
- Test robots.txt i kodu HTTP dla 8 botów AI z wnioskiem przy każdym.
- Ocenę obecnego pliku /llms.txt z liczbą linków do podstron.
- Listę pominiętych adresów z powodem (kod HTTP, noindex) i link do wyniku do skopiowania.
Nie ma tu nic do odblokowania e-mailem: cały wynik jest na stronie. Nie zapisujemy adresu ani wyniku.
Co to jest llms.txt (i llms-full.txt)
Plik llms.txt leży pod adresem /llms.txt i opisuje serwis dla modeli językowych i agentów AI, które czytają strony w imieniu użytkowników. Format zaproponował Jeremy Howard we wrześniu 2024 roku, a aktualna wersja specyfikacji (v2) jest opublikowana na llmstxt.org.
Układ jest stały. Na górze nagłówek z nazwą firmy, jedyny obowiązkowy element. Pod nim cytat z krótkim opisem, a dalej sekcje z listami linków: tytuł podstrony w nawiasach kwadratowych, adres w okrągłych i po dwukropku zdanie o tym, co tam jest. Sekcja o nazwie „Optional” zbiera linki drugorzędne, które model może pominąć, gdy ma mało miejsca. Tak wygląda początek naszego pliku llms.txt:
# AI SEO COMPANY

> Agencja SEO i web design z Warszawy. Pozycjonowanie stron, pozycjonowanie
> w AI (GEO), audyty SEO, SEO lokalne i projektowanie stron dla małych
> i średnich firm. Każdy klient dostaje panel klienta 24/7 z publicznym demo.

## Zmiana agencji

- [Zmiana agencji SEO bez kar i utraty pozycji](https://www.ai-seo-company.pl/zmiana-agencji-seo): poradnik, checklista 32 punktów (konta Google, domena, treści, linki, dane) i bezpłatny przegląd po poprzedniej agencji (30 min).
Fragment pliku https://www.ai-seo-company.pl/llms.txt, stan na 5 listopada 2026.
Niektóre serwisy publikują obok drugi, dużo dłuższy plik llms-full.txt. Nasz generator tworzy spis, czyli llms.txt: tego potrzebuje typowa strona firmowa.
Czy llms.txt pomaga w Google i ChatGPT?
Na razie brak na to dowodów. Ahrefs (odczyt 5.11.2026) nie znalazł deklaracji OpenAI, Anthropic ani Google, że ich crawlery czytają ten plik. Mimo to llms.txt publikuje 28% ze 137 000 domen, które Ahrefs zbadał w swoim narzędziu Web Analytics. Firmy wdrażają go na zapas, licząc, że modele zaczną z niego korzystać.
Sygnały z Google są sprzeczne. Zespół Chrome dodał sprawdzanie llms.txt do eksperymentalnych audytów Lighthouse, a John Mueller z Google tłumaczył, że plik nie powstał z myślą o wyszukiwaniu. Dostęp Gemini do treści reguluje się osobno, wpisem Google-Extended w robots.txt.
Nasz wniosek: llms.txt to tani dodatek, a nie strategia. Przygotowanie pliku kosztuje niewiele i niczego nie psuje, ale o tym, czy ChatGPT, Perplexity albo Claude zacytują stronę, decyduje dostęp ich botów i treść, którą da się zacytować. Dlatego generator testuje też robots.txt i odpowiedzi serwera dla 8 botów. Jeśli zależy Ci na poleceniach w odpowiedziach modeli, zacznij od pozycjonowania w AI i przeczytaj, jak pozycjonować się w ChatGPT.
Co sprawdza generator
Generator pobiera mapę strony, wybiera do 50 adresów (przy większej mapie po kilka z każdej sekcji), sprawdza je i składa z nich plik. Równolegle testuje dostęp 8 botów do strony głównej. Całość trwa najwyżej 20 sekund. Gdy strona odpowiada wolno, dostajesz wynik częściowy i listę adresów, których nie zdążyliśmy sprawdzić. Nie zapisujemy ani adresu, ani wyniku.
| Test | Po co | Jak czytać wynik |
|---|---|---|
| Mapa strony | Źródło listy podstron: wpis Sitemap w robots.txt albo /sitemap.xml, także indeks map (do 20 map podrzędnych). Przy ponad 50 adresach bierzemy po kilka z każdej mapy i sekcji, a nie pierwsze 50. Kilka adresów z błędem zastępujemy innymi z tej samej sekcji. | Bez mapy plik zawiera tylko stronę główną. Dodaj sitemap.xml i zgłoś ją w Search Console. |
| Kod odpowiedzi i przekierowania | Do pliku trafiają tylko adresy, które zwracają kod 200. | Adresy z kodem 3xx, 4xx i 5xx są na liście pominiętych razem z kodem. |
| noindex | Strona wyłączona z indeksu nie powinna trafiać do spisu. | Pomijamy adresy z noindex w meta robots albo w nagłówku X-Robots-Tag. |
| Tytuł i opis | Z nich powstają wiersze pliku: link z tytułem i opis po dwukropku. | Brak opisu = sam link. Uzupełnij meta description na tych podstronach. |
| Sekcje pliku | Podstrony grupujemy według pierwszego członu adresu (Blog, Usługi) i wersji językowej (Wersja EN, Blog (EN)). Regulamin i polityki trafiają do sekcji „Optional”, którą model może pominąć. Kontakt zostaje w „Strony”. | Sekcja potrzebuje co najmniej 2 podstron w mapie, pozostałe adresy trafiają do „Strony”. Nazwy sekcji i przydział linków zmienisz w edytorze przed pobraniem. |
| robots.txt dla 8 botów | Pokazuje, czy bot może pobrać stronę główną i ile sprawdzonych adresów blokuje. | Blokada OAI-SearchBot albo PerplexityBot wyklucza stronę z wyników ChatGPT i Perplexity. |
| Obecny plik /llms.txt | Pokazuje, czy strona ma już plik i czy zwraca go bez przekierowania. | Kod 200 i nagłówek „# Nazwa” w pierwszym wierszu = plik jest na miejscu. Pokazujemy też liczbę linków do podstron: plik bez linków w formacie [nazwa](https://adres) oznaczamy jako błąd, bo nic modelowi nie wskaże. HTML zamiast tekstu oznacza zły adres. |
| Kod HTTP z User-Agentem bota | Wykrywa blokady zapory (WAF) i CDN, których nie widać w robots.txt. | Kod 403 albo 429 dla bota przy 200 dla przeglądarki oznacza blokadę po stronie serwera. |
Zapytania wysyłamy z naszego serwera, nie z adresów IP dostawców AI, więc kolumnę z kodem HTTP traktuj jako wskazówkę.
Tak sprawdzamy też siebie. 5 listopada 2026 odpytaliśmy własną stronę 17 User-Agentami (16 botów i przeglądarka) na 7 adresach. Wszystkie 119 zapytań dostały kod 200, a nasz llms.txt miał wtedy 14 437 bajtów.
Jak poprawić plik przed wgraniem
Generator składa plik z tego, co podstrony mówią o sobie w title i meta description. Zanim wgrasz plik, otwórz edytor pod wynikiem i popraw to, czego automat nie oceni:
- Opis pod nagłówkiem: jedno-dwa zdania o tym, co robisz, dla kogo i gdzie. Model czyta go zaraz po nazwie.
- Odznacz linie bez wartości dla klienta: logowanie, koszyk, tagi, strony wyników wyszukiwania.
- Skróć tytuły, które powtarzają nazwę firmy albo są za długie. Opis ma mówić, co jest na podstronie, a nie zachęcać do kliknięcia.
- Najważniejsze podstrony przesuń na początek sekcji, a drugorzędne przenieś do „Optional”.
- Ważne podstrony, których brakuje (np. spoza mapy strony), dopisz ręcznie w tym samym formacie.
Przyciski „Kopiuj” i „Pobierz llms.txt” biorą plik już ze zmianami. Edytor działa w Twojej przeglądarce: niczego nie wysyłamy ani nie zapisujemy, więc po zmianach na stronie wygeneruj plik ponownie.
Jak wdrożyć llms.txt: WordPress, Next.js, Shopify
Niezależnie od platformy plik ma się otwierać pod adresem twojadomena.pl/llms.txt jako zwykły tekst. Po wdrożeniu wpisz adres strony w generator wyżej i porównaj wynik z plikiem.
WordPress
Najprościej użyć wtyczki SEO, którą zwykle już masz. Według katalogu WordPress.org (odczyt 5.11.2026) funkcję llms.txt mają Yoast SEO (wersja 28.8), Rank Math (1.0.281) i All in One SEO (5.0.5). Włącz ją w ustawieniach wtyczki i sprawdź, które podstrony trafiły do pliku. Bez wtyczki wgraj plik z generatora przez menedżer plików hostingu albo FTP do katalogu głównego, tam gdzie leży wp-config.php. Wybierz jeden sposób, żeby nie utrzymywać dwóch wersji pliku.
Next.js
Zapisz plik jako public/llms.txt. Next.js serwuje pliki z katalogu public pod adresem głównym, więc trafi pod /llms.txt bez dodatkowego kodu. Gdy lista podstron często się zmienia, zamiast stałego pliku użyj route handlera app/llms.txt/route.js, który składa treść z tych samych danych co sitemapa i zwraca ją z nagłówkiem Content-Type: text/plain. Nowa podstrona trafi wtedy do llms.txt razem z wdrożeniem.
Shopify
Shopify to platforma hostowana: nie wgrasz pliku przez FTP do katalogu głównego domeny. Społeczność Shopify opisuje dwa obejścia: własny szablon motywu llms.txt.liquid albo przekierowanie adresu /llms.txt na plik dodany w sekcji Pliki. Shopify nie opisał tego w oficjalnej dokumentacji, więc po zmianie otwórz adres pliku w przeglądarce. Pewniejszy jest plik dostępny pod /llms.txt bez przekierowania.
Plik gotowy, a modele dalej nie polecają firmy?
W audycie widoczności w AI zadajemy 30 pytań Twoich klientów w ChatGPT, Perplexity, Gemini i przeglądzie AI Google i pokazujemy, z jakich stron modele biorą polecenia. Więcej bezpłatnych narzędzi i wzorów jest w dziale narzędzia i szablony.
Poradniki do tego narzędzia
- Pozycjonowanie w ChatGPT: skąd bierze firmy, które poleca: 7 kroków, żeby model wymieniał Twoją
- SEO vs GEO: czym się różnią i od czego zacząć: porównanie w 8 kryteriach
- Audyt techniczny SEO: checklista z progami i arkusz: progi dla każdego punktu, żeby wiedzieć, co naprawić najpierw
Inne darmowe narzędzia
- Darmowy audyt SEOocena 1-100 i lista błędów dla do 25 podstron
- Widoczność w AIczy ChatGPT, Gemini, Perplexity, Claude i przegląd AI w Google wymieniają Twoją firmę
- Kalkulator strat bez SEOile zysku miesięcznie tracisz bez TOP 3 w Google i poleceń w AI
- Makieta nowej stronynowa strona główna z AI w 1-3 minuty, z Twoich treści
- Autorytet domenywynik 0-100 z grafu linków Common Crawl i porównanie z maksymalnie 3 konkurentami
- Wszystkie darmowe narzędzia i szablonypełna lista razem z szablonami SEO do pobrania
Pytania o llms.txt
Nie. robots.txt mówi botom, czego nie wolno pobierać, i boty wyszukiwarek oraz AI go respektują. llms.txt to dobrowolny spis najważniejszych podstron w formacie Markdown, bez mocy blokowania. Jeśli w robots.txt zablokujesz OAI-SearchBot, żaden llms.txt nie sprawi, że ChatGPT zacytuje Twoją stronę.
W katalogu głównym domeny, tak żeby otwierał się pod adresem twojadomena.pl/llms.txt i zwracał kod 200 jako zwykły tekst. Specyfikacja dopuszcza też plik w podkatalogu, np. /docs/llms.txt, ale opisuje on tylko adresy pod tą ścieżką. Plik za przekierowaniem łatwo przeoczyć. Po wdrożeniu otwórz adres w przeglądarce i sprawdź go w generatorze.
llms.txt to spis: tytuły podstron z linkami i krótkimi opisami. llms-full.txt to zwyczajowa nazwa pliku z pełną treścią tych podstron w jednym dokumencie Markdown; specyfikacja llmstxt.org go nie opisuje. Pełna wersja ma sens przy dokumentacji technicznej, z której korzystają asystenci programistów. Dla strony firmowej z kilkudziesięcioma podstronami wystarczy spis.
To decyzja biznesowa. GPTBot zbiera dane do trenowania modeli OpenAI, a OAI-SearchBot indeksuje strony na potrzeby wyszukiwania w ChatGPT. Możesz zablokować pierwszego i wpuścić drugiego. Jeśli zależy Ci na obecności w odpowiedziach ChatGPT, nie blokuj OAI-SearchBot.
Nie w wyszukiwarce. Przedstawiciele Google mówili publicznie, że plik nie służy do wyszukiwania, a dostęp Gemini do treści kontroluje się wpisem Google-Extended w robots.txt. llms.txt nie poprawi pozycji w Google ani nie zapewni miejsca w przeglądzie AI.
Sprawdzamy do 50 adresów: przy większej mapie bierzemy po kilka z każdej mapy podrzędnej i sekcji (do 20 map). Pomijamy adresy z kodem innym niż 200 i z noindex, a pod wynikiem pokazujemy listę pominiętych i tych, których nie zdążyliśmy sprawdzić w 20 sekund. Kilka adresów z błędem zastępujemy innymi z tej samej sekcji. Brakujące ważne podstrony dopisz ręcznie w tym samym formacie.
To sekcja opisana w specyfikacji llmstxt.org: linki, które model może pominąć, gdy ma mało miejsca. Generator wkłada tam regulamin oraz polityki prywatności i cookies, a kontakt i ważne podstrony zostawia w sekcjach wyżej. W edytorze pod wynikiem przeniesiesz do niej inne drugorzędne linki. Nazwy „Optional” nie tłumacz, bo to nazwa ze specyfikacji.
Nie. Cały plik i test botów widzisz od razu na stronie, bez rejestracji i bez e-maila. Nie zapisujemy adresu ani wyniku. Limit to 10 sprawdzeń dziennie z jednego adresu IP.
Tak. Pod wynikiem otwórz „Edytuj plik przed pobraniem”: odznaczysz linie, których nie chcesz w pliku, zmienisz nazwę, opis firmy, tytuły i opisy linków, kolejność i sekcje, a drugorzędne linki przeniesiesz do „Optional”. Przyciski „Kopiuj” i „Pobierz llms.txt” biorą plik już ze zmianami. Edycja działa w Twojej przeglądarce i niczego nie zapisujemy.
Źródła
- llmstxt.org: The /llms.txt file, v2 (specyfikacja formatu) (odczyt: 5.11.2026)
- Ahrefs: What is llms.txt (analiza 137 000 domen, wypowiedź Johna Muellera) (odczyt: 5.11.2026)
- OpenAI: Overview of OpenAI Crawlers (GPTBot, OAI-SearchBot, ChatGPT-User) (odczyt: 5.11.2026)
- Google: Google-Extended w dokumentacji crawlerów (odczyt: 5.11.2026)
- Anthropic: ClaudeBot, Claude-SearchBot i Claude-User (odczyt: 5.11.2026)
- Perplexity: PerplexityBot i Perplexity-User (odczyt: 5.11.2026)
- Katalog wtyczek WordPress.org: Yoast SEO (wersja 28.8) (odczyt: 5.11.2026)
- Katalog wtyczek WordPress.org: Rank Math SEO (wersja 1.0.281) (odczyt: 5.11.2026)
- Katalog wtyczek WordPress.org: All in One SEO (wersja 5.0.5) (odczyt: 5.11.2026)